

10月20日,DeepSeek宣布将在之前开源一系列大模型、TileLang编译工具及推理算子库的基础上,进一步全面开源内部推理框架“DeepInfer”,并同步开放编解码组件deepseek-recipe。此举旨在降低使用成本。
DeepSeek公开的信息显示,推理框架DeepInfer集成高性能算子与深度优化的推理引擎,支持分布式推理、推测解码、SWA Bounded Replay、结构化输出等能力,并兼容英伟达与华为昇腾算力平台。配套开源的deepseek-recipe用于处理应用请求与模型输入、输出之间的转换,帮助第三方部署对齐官方API的处理逻辑。
DeepSeek表示,大模型的能力边界由模型本身划定,但如何以合理成本提供超大规模的模型服务还取决于一个长期未被公众了解的中间层,即推理框架。面对如今海量的用户调用,推理框架负责统筹调度庞大的算力集群,其效率直接决定了AI服务的算力成本与电力消耗。DeepSeek长期致力于将推理性能推向极致,因此做出这一开源决定,致力于实现大模型普惠。
基于DeepInfer,DeepSeek已实现DeepSeek V4.1 Flash的高吞吐、低延迟大规模推理服务。后续新模型的推理代码及优化也将在该框架内持续更新。在全球头部大模型企业中,DeepSeek是首个开放原生实际运行推理框架的企业。这意味着云厂商可以使用DeepSeek原生推理框架部署DeepSeek模型,实现接近DeepSeek官方调用的性能和成本。在负载调度合理的情况下,大规模云厂商部署非原生DeepSeek的调用成本甚至存在低于官方原生的可能性。
DeepSeek希望通过分享内部的部署经验,帮助开发者与企业组织优化大规模推理的吞吐与延迟,从而高效构建私有化及公有云部署,降低算力成本,减少能源消耗,让智能以更低的价格触达更广泛的人群,实现真正的大模型普惠。
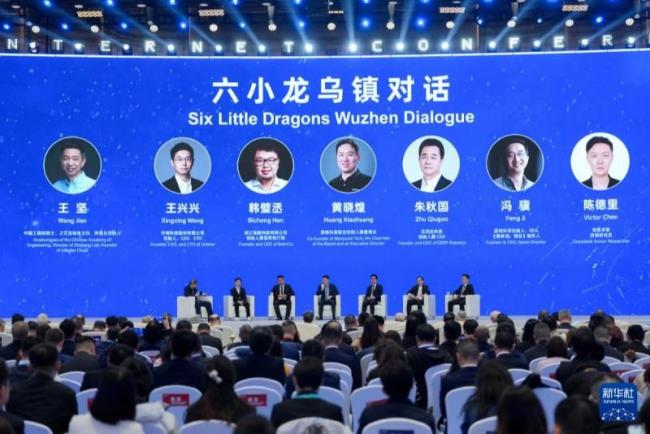
2025年乌镇峰会期间,举行了“六小龙乌镇对话”,前沿科技企业代表围绕全球人工智能技术创新发展等前沿趋势进行交流,探索通过跨界合作共同应对全球性议题。2026年乌镇峰会将于11月2日至5日举行,聚焦“开源开放”主题。届时,全球嘉宾将围绕人工智能开源开放发展的理念与实践多个维度展开深入交流,共同探索在AI快速发展的阶段如何进一步推动技术开放、创新协作和成果共享。